Wer baut das nächste GitHub? Code, KI und die Macht dahinter
Ai SecurityInhaltsverzeichnis
GitHub ist eine Plattform, auf der Menschen Software ablegen, gemeinsam entwickeln und veröffentlichen. Dahinter steckt Git, ein Werkzeug zur Versionsverwaltung: Es hält Änderungen an Dateien nachvollziehbar fest, erlaubt parallele Entwicklungszweige und hilft dabei, unterschiedliche Arbeitsstände wieder zusammenzuführen. Git ist das technische Fundament. GitHub ergänzt darum die Zusammenarbeit, etwa mit Fehlermeldungen, Diskussionen, Pull Requests und automatisierten Abläufen.
Git entstand 2005 aus der Entwicklung des Linux-Kernels. GitHub wurde 2008 gegründet und ging am 10. April 2008 öffentlich an den Start. Zehn Jahre später kaufte Microsoft das Unternehmen für 7,5 Milliarden US-Dollar; den Abschluss der Übernahme meldete Microsoft am 26. Oktober 2018. Aus einem Zuhause für Entwickler wurde eine zentrale Infrastruktur der Softwarewelt. Git-Geschichte, GitHub-Start, Microsoft-Übernahme
Und 2026 fühlt es sich plötzlich so an, als hätte auch jeder zweite Mensch außerhalb der klassischen Softwareentwicklung einen GitHub-Account. Eine kleine App hier, ein persönliches Dashboard dort, ein KI-Werkzeug, das zur Verbindung mit einem Repository auffordert. Das ist meine zugespitzte Wahrnehmung, keine Statistik über Nichtentwickler. Die interessante Veränderung dahinter ist trotzdem real: Der Zugang zum Bauen von Software wird einfacher, während die Infrastruktur darunter neue Last tragen muss.
Genau deshalb finde ich die Frage spannend, wer das nächste GitHub baut. Anthropic hat seine interne Versionsverwaltung neu entwickelt. Cloudflare stellt Bausteine für neue Git-Plattformen bereit. Gleichzeitig wird GitHubs Zuverlässigkeit öffentlich hinterfragt. Dabei geht es um viel mehr als einen schöneren Merge-Button. Es geht darum, wer künftig den Ort kontrolliert, an dem Software entsteht, geprüft wird und ihren Weg in den Betrieb findet.
Wenn aus Nutzern plötzlich Softwarebauer werden
Die Entwicklung begann vor diesem Jahr. GitHub meldete im Octoverse-Bericht 2025 bereits mehr als 180 Millionen Entwickler und über 36 Millionen neue Nutzer innerhalb eines Jahres. Nahezu 80 Prozent der neuen Entwickler nutzten laut GitHub Copilot innerhalb ihrer ersten Woche. Das ist eine Herstellererhebung und kein Beweis, dass KI allein das Wachstum verursacht hat. Es zeigt aber, wie eng der Einstieg in GitHub inzwischen mit KI-Werkzeugen verbunden ist.
Früher musste man für ein kleines Werkzeug oft zuerst genug Programmierung lernen, um überhaupt einen brauchbaren Anfang hinzubekommen. Heute lässt sich eine Idee beschreiben und mit einem Coding-Agenten schrittweise umsetzen. Fachwissen bleibt notwendig, besonders sobald Daten, Berechtigungen und produktive Systeme ins Spiel kommen. Die Hürde zwischen einer Idee und einem ersten funktionierenden Programm ist trotzdem deutlich kleiner geworden.
Für Open Source sehe ich darin enormes Potenzial: Dokumentation verständlicher machen, Tests ergänzen, Fehler eingrenzen, Schnittstellen erschließen und liegengebliebene Ideen wieder aufnehmen. Das sind konkrete Möglichkeiten, wie KI Entwicklung beschleunigen kann. Daraus folgt allerdings keine allgemeine Qualitätssteigerung jedes Projekts. Ein zusätzliches Repository ist noch keine gepflegte Software, und ein zusätzlicher Pull Request kann einem Maintainer auch zusätzliche Arbeit machen.
Mich interessiert deshalb weniger, wie viele Zeilen ein Agent erzeugt. Interessanter ist, wie viel davon verstanden, geprüft und langfristig gepflegt werden kann. Wenn Code schneller entsteht, wandert der Engpass zu den Menschen und Systemen, die entscheiden müssen, welcher Code bleiben darf.
Der Weihnachtsbaum auf der Statusseite
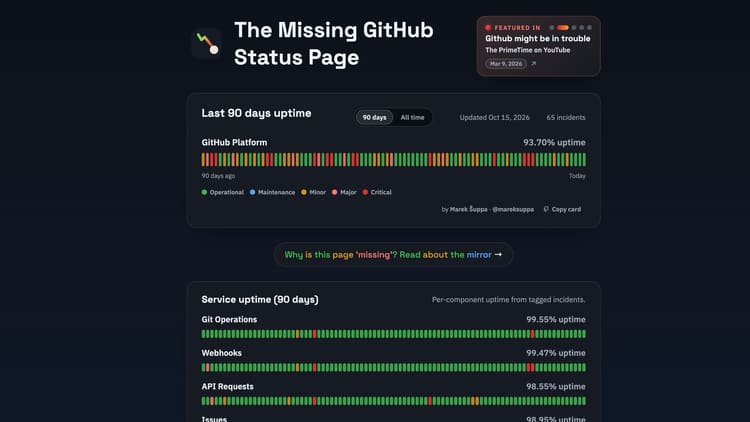
Das Headerbild zeigt The Missing GitHub Status Page von Marek Šuppa. Der Screenshot trägt den Stand 15. Oktober 2026 und nennt für ein 90-Tage-Fenster 65 Vorfälle sowie 93,70 Prozent Plattformverfügbarkeit. Für Git Operations stehen dort dagegen 99,55 Prozent. Diese Zahlen gehören zu dieser Aufnahme und sind keine von mir neu gemessenen aktuellen Verfügbarkeitswerte.
Die inoffizielle Seite rekonstruiert Zeitfenster aus veröffentlichten Statusmeldungen und führt überlappende Störungen zusammen. Ein Plattformwert bündelt unterschiedliche Dienste; er sagt nicht, dass Git-Klone, Pull Requests und Actions während jeder erfassten Störung gleichzeitig für alle Nutzer ausgefallen wären. Aus 93,70 Prozent werden deshalb nicht einfach „GitHub war 6,30 Prozent der Zeit komplett offline“. Die Aussage hängt von der Aggregation und den erfassten Vorfällen ab.
Trotzdem trifft das Bild einen empfindlichen Punkt. Eine Versionsplattform ist inzwischen ein Teil der Produktionskette. Ein nicht erreichbarer Review, ein blockierter Build oder eine gestörte Schnittstelle können einen Release aufhalten, obwohl der Quellcode lokal vollständig vorhanden ist. Für den betroffenen Ablauf zählt dann, ob seine gesamte Kette funktioniert.
Die Statusdarstellung allein belegt auch nicht, dass KI diese Vorfälle verursacht hat. Sie erklärt, warum die Frage nach Alternativen Aufmerksamkeit bekommt. Die Ursachen einzelner Störungen muss man anhand der jeweiligen Incident-Berichte beurteilen.
Warum Git und GitHub getrennt betrachtet werden müssen
Ein GitHub-Ausfall ist zunächst kein Fehler im Git-Datenmodell. Mit einer vollständigen lokalen Git-Kopie kann ich weiter Änderungen festhalten, ältere Versionen vergleichen und Entwicklungszweige bearbeiten. Für diese Arbeit brauche ich keinen permanent erreichbaren Plattformanbieter. Diese Unabhängigkeit gehört für mich zu den wertvollsten Eigenschaften von Git.
Anders sieht es bei den Diensten aus, die ein Team um das Repository gebaut hat. Wenn Freigaben, Tests, Artefakte und Deployment an einer Plattform hängen, reicht die lokale Kopie nicht mehr aus, um den gesamten Prozess fortzusetzen. Der Code ist verteilt, der Arbeitsablauf möglicherweise stark zentralisiert.
Damit entstehen zwei verschiedene Aufgaben: Eine Plattform muss zuverlässig arbeiten. Und eine Versionsverwaltung muss zum Datenvolumen und zur Arbeitsweise ihrer Nutzer passen. Ein anderer Hostinganbieter löst nicht automatisch jedes Skalierungsproblem. Umgekehrt rechtfertigt eine schwierige Plattformphase noch keinen vollständigen Austausch von Git.
Anthropic baut Scion für eine ungewöhnliche Größenordnung
Anthropic berichtet von etwa 2.500 zusammengeführten Änderungen pro Tag im Mai 2026 und mehr als 30.000 im September. Die Historie des Hauptzweigs erreiche fast 100 GB, die komprimierte Arbeitskopie über 25 GB. Dazu kämen ungefähr 25 Millionen Checkouts täglich allein für CI. Die genannten über 600 PB täglicher Übertragungen sind eine Hochrechnung für naives vollständiges Abrufen, kein gemessener tatsächlicher Tagesverkehr.
Die Antwort heißt Scion. Anthropic beschreibt eine Migration innerhalb von fünf Monaten, zusammen mit dem Review-Werkzeug Antique und weiterer interner Infrastruktur. Scion setzt auf ständig verbundene Clients und verlagert Versionsoperationen auf den Server. Dateien werden bedarfsgerecht geladen, viele Abfragen direkt per API beantwortet. Ein Job braucht damit nicht für jede Frage eine lokale Repository-Kopie.
Entscheidend ist die Grenze, die Anthropic selbst zieht: Scion ist kein allgemeiner Git-Ersatz und kein angekündigtes öffentliches GitHub für alle. Das System ist auf enorme Monorepositories und die eigene Agentenlast zugeschnitten. Anthropic will Erkenntnisse auch mit dem bestehenden Git-Ökosystem teilen. Die plakative Aussage „Anthropic baut das nächste GitHub“ trifft deshalb höchstens die technische Neuorientierung, nicht ein bereits verfügbares Konkurrenzprodukt.
Warum ein kleiner Client einen großen Unterschied machen kann
Der Grundgedanke hinter dieser Architektur lässt sich auch ohne Anthropic-Größenordnung verstehen. Stellt euch vor, ein automatisierter Auftrag soll prüfen, ob sich eine bestimmte Konfigurationsdatei zwischen zwei Versionen verändert hat. Dafür braucht er eine Antwort auf eine eng umrissene Frage. Eine umfangreiche lokale Arbeitsumgebung aufzubauen, kann erheblich mehr Aufwand verursachen als die eigentliche Prüfung.
Bei einem einzelnen Auftrag fällt das vielleicht kaum auf. Bei sehr vielen kurzlebigen Umgebungen können wiederholte Einrichtung, Datenübertragung und Aufräumarbeit einen großen Teil der Ressourcen verbrauchen. Ein Dienst, der genau die benötigten Daten liefert, verändert diese Rechnung. Das ist eine architektonische Abwägung, kein Beweis dafür, dass jedes kleine Repository künftig einen zentralen Versionsserver benötigt.
Die Gegenleistung ist eine stärkere Abhängigkeit vom erreichbaren Dienst. Wer mehr Arbeit auf einen Server verlagert, muss dessen Ausfälle, Berechtigungen, Wiederherstellung und Kapazitätsgrenzen entsprechend ernst nehmen. Weniger lokale Daten sind bequem, bis der entfernte Dienst nicht antwortet.
Mir gefällt, dass hier eine gewohnte Annahme hinterfragt wird. Ich würde daraus trotzdem keine pauschale Empfehlung ableiten. Für ein überschaubares Projekt kann die vollständige lokale Git-Historie genau das richtige Verhältnis aus Einfachheit, Geschwindigkeit und Unabhängigkeit bieten.
Cloudflare hält an Git fest und macht Repositories programmierbar
Cloudflare geht mit Artifacts einen anderen Weg. Der im April vorgestellte Dienst bietet versionierten Speicher mit Git-kompatibler Schnittstelle. Repositories lassen sich über APIs erzeugen, importieren und forken; normale Git-Clients können damit arbeiten. Als Anwendungsfälle nennt Cloudflare getrennte Repositories für Projekte, Aufgaben oder Agentensitzungen sowie versionierten Code und Kontext. Der technische Unterbau soll sich programmatisch bereitstellen lassen, statt jedes Repository als manuell eingerichteten Dauerarbeitsplatz zu behandeln.
Das macht Git-Kompatibilität strategisch interessant. Bestehende Werkzeuge und eingeübte Abläufe erleichtern den Einstieg. Wer ein neues Produkt entwickelt, kann sich zunächst auf die Zusammenarbeit konzentrieren, anstatt zugleich ein völlig neues Versionsprotokoll einführen zu müssen.
Im Oktober meldete Cloudflare die offene Beta für Kunden mit kostenpflichtigem Workers-Tarif. Neuere Integrationen verbinden Artifacts mit Workers Builds und Vorschauumgebungen. Ereignisse können automatisierte Reviews anstoßen; repositorybezogene Tokens begrenzen den Zugriff. Cloudflare lädt ausdrücklich andere dazu ein, auf Workers und Artifacts die nächste Git-Plattform zu entwickeln. Das ist ein Infrastrukturangebot mit Plattformambition, noch kein vollständiges GitHub mit gleichwertigem sozialem und organisatorischem Ökosystem.
Für mich liegt der interessante Unterschied darin, wo die Grenze gezogen wird. Anthropic optimiert ein eigenes, riesiges Entwicklungssystem. Cloudflare bietet eine Grundlage an, auf der viele andere ihre Produkte bauen können. Die eigentliche Oberfläche für Menschen, Agenten und gemeinsame Entscheidungen bleibt ein eigenes Produktproblem.
Warum diese Unternehmen dort hinwollen
Der unmittelbar belegte Grund bei Anthropic ist der eigene Engpass. Wenn Forschung und Produktentwicklung auf Versionsoperationen warten, kostet das Zeit und Rechenkapazität. Eine bessere interne Infrastruktur hat einen Nutzen, selbst wenn Scion niemals ein öffentliches Produkt wird.
Darüber hinaus sehe ich ein strategisches Interesse, Coding-Agenten über längere Arbeitsabläufe hinweg nützlich zu machen. Ein Modell, das eine Funktion schreiben kann, ist wertvoll. Ein Agent, der sich in einem Projekt zurechtfindet, Änderungen prüfbar vorbereitet und mit der bestehenden Infrastruktur zusammenspielt, kann viel tiefer im Arbeitsalltag verankert werden. Das ist meine wirtschaftliche Einordnung, kein von Anthropic bestätigter Vermarktungsplan für Scion.
Bei Cloudflare ist der Zusammenhang mit dem Infrastrukturgeschäft direkter: Wer Anwendungen auf Workers betreibt und ihre Entwicklungsdaten in Artifacts hält, nutzt weitere Teile derselben Plattform. Cloudflare nennt für Artifacts eine Abrechnung nach Operationen und gespeicherter Datenmenge. Mehr Agenten können mehr Repositories, mehr Zugriffe und mehr Rechenarbeit bedeuten. Ob sich ein konkreter Workflow wirtschaftlich lohnt, hängt von seiner tatsächlichen Nutzung ab.
Dazu kommt die Bindung durch Integration. Ein Git-Repository lässt sich oft vergleichsweise einfach an einen anderen Ort übertragen. Ein System aus projektspezifischen APIs, Agentenabläufen, Ereignissen, Berechtigungen, Vorschauen und Deployment ist schwieriger umzuziehen. Je mehr davon bequem zusammenspielt, desto größer wird der praktische Aufwand eines Anbieterwechsels.
Diese Motive widersprechen dem technischen Nutzen nicht. Ein Dienst kann ein echtes Problem lösen und gleichzeitig die Position seines Anbieters stärken. Genau deshalb möchte ich beide Seiten sehen, bevor aus einer angenehmen Integration eine kaum noch hinterfragte Abhängigkeit wird.
Im Code steckt mehr als Programmtext
Und ja, Trainingsdaten gehören für mich in diese Diskussion. Als mögliches strategisches Interesse verdienen sie Aufmerksamkeit. Als pauschale Erklärung für jede neue Git-Plattform wären sie zu bequem.
Ein Repository enthält oft weit mehr als die aktuelle Lösung. In seiner Geschichte kann sichtbar werden, welcher Ansatz zuerst versucht wurde, welcher Test scheiterte, weshalb ein Review eine Änderung zurückwies und welche Korrektur am Ende akzeptiert wurde. Für die Entwicklung von Coding-Systemen ist ein solcher Zusammenhang potenziell besonders wertvoll: Aufgabe, Versuch, Rückmeldung und überprüfbares Ergebnis stehen miteinander in Beziehung.
Ein frei erfundenes Beispiel macht das greifbar. Ein Agent soll einen Fehler in einer Datumsberechnung beheben. Sein erster Vorschlag besteht die vorhandenen Tests, fällt aber bei einem neu ergänzten Jahreswechsel-Test durch. Ein Reviewer erklärt die falsche Annahme, die nächste Änderung behebt sie. Der Lernwert läge hier nicht nur im fertigen Stück Code, sondern im Weg vom plausiblen Fehler zur begründeten Lösung. Ob ein Anbieter solche Daten tatsächlich nutzt und nutzen darf, ist eine davon getrennte Frage.
Der Wert von Code verschwindet deshalb auch nicht einfach, wenn seine Erzeugung günstiger wird. Verlässliche Anforderungen, dokumentierte Entscheidungen, gute Tests, Wartungserfahrung und ein nachweislich funktionierendes Zusammenspiel bleiben aufwendig. Ein Berg erzeugter Dateien ersetzt diese Arbeit nicht. Gerade wenn beliebig viele Vorschläge entstehen können, werden belastbare Hinweise darauf wertvoll, welcher davon eine Aufgabe wirklich löst.
Das ist meine Einschätzung des wirtschaftlichen und technischen Potenzials. Die hier besprochenen Ankündigungen belegen weder, dass Anthropic fremde private Repositories über Scion einsammelt, noch dass Cloudflare Artifacts zum Training eines eigenen Coding-Modells betreibt.
Was beim Training tatsächlich unterschieden werden muss
Dass Entwicklungsdaten für KI interessant sind, ist keine rein theoretische Vermutung. GitHub erklärte im März 2026, ab dem 24. April Interaktionsdaten bestimmter persönlicher Copilot-Tarife für Modelltraining zu verwenden, sofern Nutzer nicht widersprechen. GitHub unterscheidet dabei ausdrücklich zwischen Daten aus aktiven Copilot-Interaktionen und ruhenden Repository-Inhalten: Die gespeicherten privaten Repositories würden dafür nicht pauschal ausgelesen. Für Copilot Business und Enterprise gelten andere Schutzregeln. GitHubs Erklärung zur Datennutzung
Anthropic erklärt seinerseits für kommerzielle Produkte, Ein- und Ausgaben standardmäßig nicht für das Modelltraining zu verwenden. Freiwillig bereitgestelltes Feedback und ausdrückliche Teilnahme an entsprechenden Programmen können gesondert behandelt werden. Diese Aussage ist keine allgemeine Zusage für jeden privaten Tarif und jede Einstellung. Anthropics Erklärung für kommerzielle Produkte
Deshalb würde ich bei einem neuen Dienst konkret wissen wollen, welche Inhalte nur gespeichert, welche zur Beantwortung einer Anfrage verarbeitet und welche zur Produktverbesserung oder zum Training verwendet werden. Das sind unterschiedliche Vorgänge. Ein Agent muss Code verarbeiten können, um daran zu arbeiten; daraus folgt noch keine Erlaubnis, ihn dauerhaft in ein Modell einfließen zu lassen.
Ebenso wenig liefert die Bezeichnung Open Source allein eine vollständige Antwort auf sämtliche Nutzungsfragen. Öffentlich sichtbarer Code, seine Lizenz, vertrauliche Bestandteile und die Bedingungen eines Dienstes müssen auseinandergehalten werden. Für mich gehört eine verständliche Datennutzungsregel genauso zum Produkt wie eine brauchbare API.
Das nächste GitHub muss bessere Entscheidungen ermöglichen
Die bequemste Zukunftsvorstellung wäre eine Plattform, auf der beliebig viele Agenten beliebig viel Code erzeugen und andere Agenten alles automatisch freigeben. Mich überzeugt das nicht. Wenn mehrere Systeme dieselbe falsche Annahme teilen, entsteht durch ihre gegenseitige Zustimmung noch kein unabhängiger Nachweis.
Eine brauchbare Plattform müsste nachvollziehbar machen, welchen Auftrag eine Änderung erfüllt, auf welchem Ausgangsstand sie beruht, welche Prüfungen gelaufen sind und wer die Verantwortung für ihre Übernahme trägt. Parallel entwickelte Änderungen können für sich korrekt erscheinen und gemeinsam etwas beschädigen. Das Problem verschwindet nicht mit einem schnelleren Merge.
Auch der Kontext eines Agenten verdient Grenzen. Aufgabenbeschreibungen, Protokolle und Konfigurationsdateien können Informationen enthalten, die nicht in jedes Repository oder jede fremde Ausführungsumgebung gehören. Wer Agentensitzungen dauerhaft speichert, baut neben einer Entwicklungshilfe auch einen neuen Datenbestand auf. Dessen Zugriff und Lebensdauer sollte man bewusst gestalten.
Für Open Source bleibt außerdem die menschliche Seite entscheidend: Vertrauen in Maintainer, nachvollziehbare Diskussionen und die Bereitschaft, ein Projekt über Jahre zu betreuen. Das lässt sich durch schnelleres Hosting unterstützen. Es lässt sich nicht allein durch mehr automatisierte Aktivität ersetzen.
GitHub ist herausgefordert, die Nachfolge aber offen
Ich halte es für gesund, dass selbst grundlegende Werkzeuge wieder zur Diskussion stehen. KI kann Menschen mehr Möglichkeiten geben, eigene Software zu bauen. Dann dürfen wir auch fragen, ob die bisherigen Plattformen für die daraus entstehende Arbeit noch gut passen.
Anthropic zeigt einen speziellen internen Umbau. Cloudflare öffnet Infrastruktur für neue Produkte. GitHub bringt weiterhin ein gewachsenes Ökosystem mit, das eine Alternative erst ersetzen oder sinnvoll ergänzen müsste. Eine neue Speicherarchitektur allein entscheidet diesen Wettbewerb nicht.
Für mich lautet die interessante Frage deshalb: Wer schafft es, mehr Menschen und Agenten produktiv zusammenarbeiten zu lassen, ohne Nachvollziehbarkeit, Unabhängigkeit und Kontrolle über ihre Daten zu verlieren? Dort liegt der Maßstab für das nächste GitHub. Und dort liegt vermutlich auch ein erheblicher Teil des Geschäfts.
Bis zum nächsten Mal,
Euer Joe
Quellen
- GitHub Octoverse 2025: Wachstum und KI-Nutzung
- GitHub: Nutzung von Copilot-Interaktionsdaten für Modelltraining
- The Missing GitHub Status Page: Rekonstruktion und Methodik
- Anthropic: Neuentwicklung der internen Versionsverwaltung mit Scion
- Cloudflare: Artifacts als versionierter Git-kompatibler Speicher
- Cloudflare: Offene Artifacts-Beta und die nächste Git-Plattform